Microsoft Agent Framework 向量上下文:让长期记忆可搜索,但不无限塞入上下文
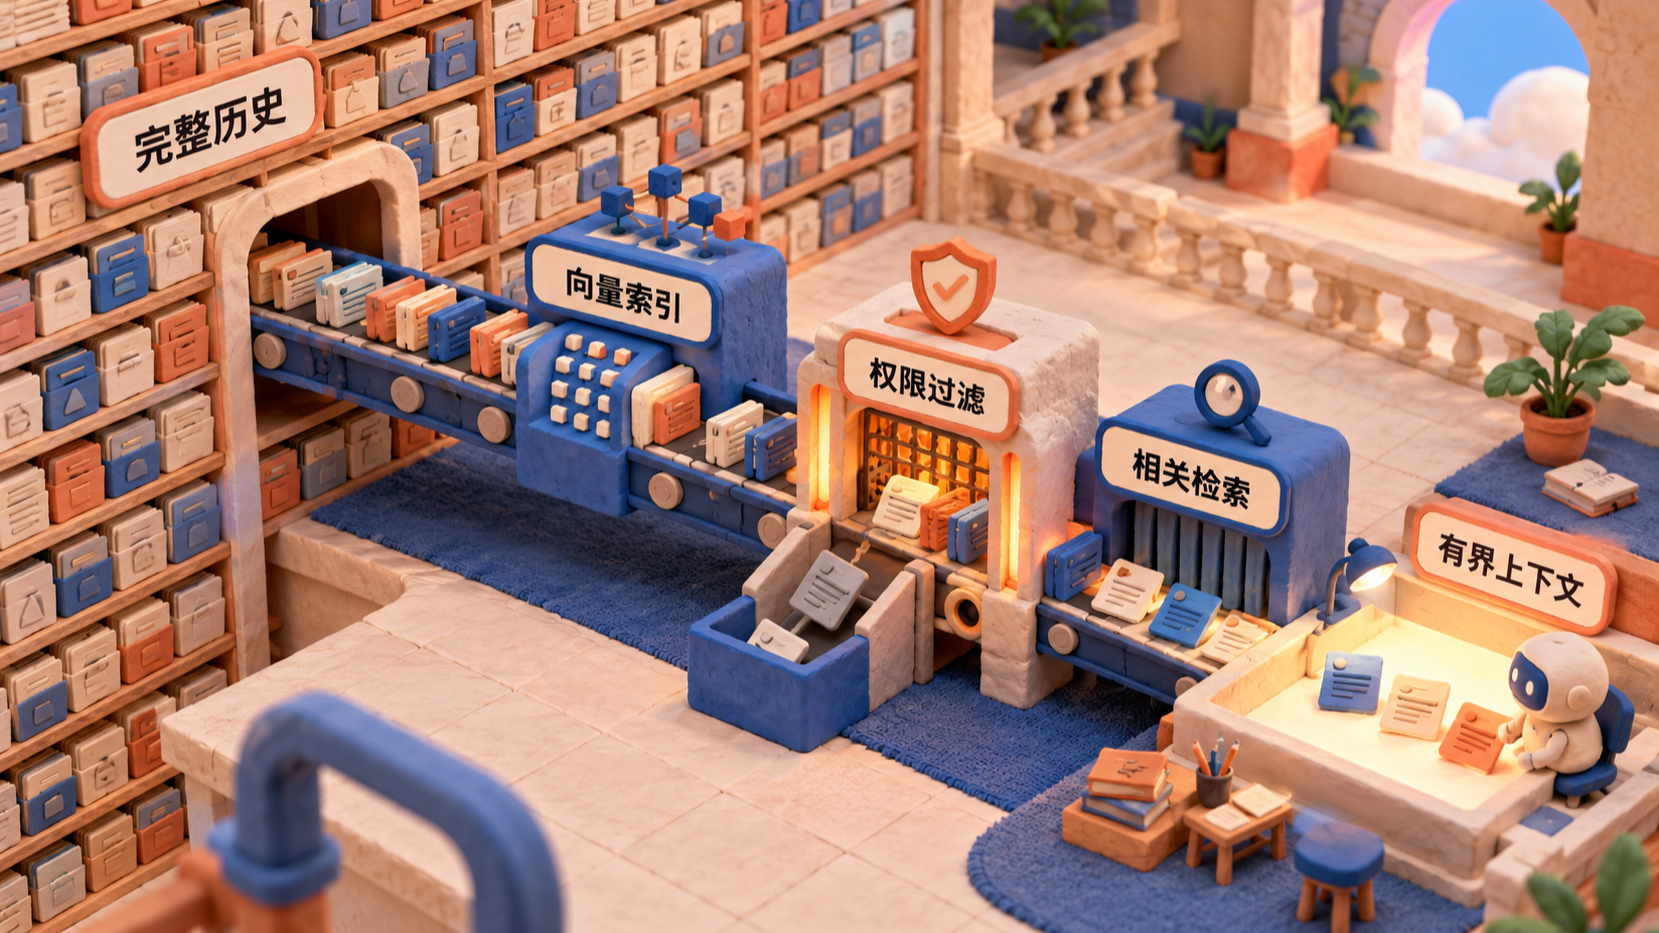
2026 年 10 月 15 日,Microsoft Agent Framework 发布 Python 向量存储支持:开发者从自己的数据模型定义 key、data 与 vector 字段,框架生成 collection;VectorCollectionContextProvider 将检索或受控写入作为 Agent 工具,VectorStoreHistoryProvider 则把完整对话保存在可搜索集合中,只把紧凑工作集放回模型上下文。
官方同时明确:向量存储 API 仍是 experimental,各集成包处于 alpha 或 beta。它适合进入架构验证,但不能因为抽象统一就假设不同数据库的过滤、混合检索和一致性语义完全相同。
长期记忆应保持可检索,当前上下文应保持有界;二者不是同一个存储层。
类型先于数据库实现
框架用 VectorStoreField 和 @vectorstoremodel 从业务对象生成 collection 定义:
from dataclasses import dataclass
from typing import Annotated
from agent_framework import VectorStoreField, vectorstoremodel

@vectorstoremodel(collection_name="run_memories")
@dataclass
class RunMemory:
    id: Annotated[str, VectorStoreField("key")]
    tenant_id: Annotated[str, VectorStoreField("data", is_indexed=True)]
    subject_id: Annotated[str, VectorStoreField("data", is_indexed=True)]
    text: Annotated[str, VectorStoreField("data")]
    vector: Annotated[list[float], VectorStoreField("vector", dimensions=1536)]
维度随模型定义保存,生成或外部提供的向量在写入前就能校验。企业还应加入来源、敏感级别、授权快照、保留期限和 embedding 版本。没有这些字段,检索正确性和合规删除都无法实现。
Context Provider 是权限边界
将 collection 包装成工具时,不应默认同时开放 upsert、get、delete、search。知识库通常只读;用户偏好可以写入但需范围限制;删除涉及审计和保留策略,不能交给模型自由调用。
provider = VectorCollectionContextProvider(
    collection=collection,
    tools=["search"],
    filter=lambda ctx: (
        RunMemory.tenant_id == ctx.tenant_id
    ) & (
        RunMemory.subject_id == ctx.user_id
    ),
    instructions="仅检索当前租户和当前用户的已批准记忆。",
)
这里是简化示意,但原则必须落实在服务端过滤器:租户条件不能由模型作为可选参数提供。涉及写入时先生成候选记忆,经过分类器或用户确认后再持久化。
对话历史不等于长期记忆
VectorStoreHistoryProvider 可以保存完整会话并按需找回旧决策,但逐轮原文包含大量噪声、错误假设和过期授权。建议分三层:事件日志保存原始事实;工作摘要保存当前目标和未完成事项;长期记忆只保留经过筛选、带来源和过期时间的条目。
def memory_candidate(turn) -> bool:
    return (
        turn.user_confirmed
        and turn.kind in {"preference", "constraint", "stable_fact"}
        and not turn.contains_secret
    )
检索时同时使用相似度、时间衰减、权限与类型过滤。纯向量 Top-K 容易把语义相近但已撤销的旧决定放回上下文。
后端可替换不代表行为等价
官方列出的集成包括 Azure AI Search、Cosmos DB、MongoDB、Redis、SQL Server、PostgreSQL/pgvector、DuckDB、Qdrant 等。抽象统一了核心操作,但索引刷新延迟、事务、混合检索、过滤表达式和距离度量仍不同。
建立后端契约测试:同一批数据验证租户过滤永不遗漏、删除后不可检索、embedding 维度错误被拒绝、并发 upsert 的最终版本确定、混合搜索排序在容忍区间内。切换后端前先双写和影子查询,而不是直接替换连接字符串。
记忆质量需要单独评测
记录检索命中是否被 Agent 实际使用、是否帮助任务、是否造成错误约束、检索 token 占比和过期记忆命中率。对敏感记忆执行可证明删除,并清理向量、原文、缓存与备份索引。
向量 Context Provider 解决了框架接线问题,但生产质量仍取决于记忆的准入、作用域、版本和删除。Agent 记得越多不一定越聪明;它只应该在需要时找回仍然有效、仍然授权、能说明来源的内容。