企业 Agent 的语义层:不要让模型在 Prompt 里重新发明指标、连接与行权限
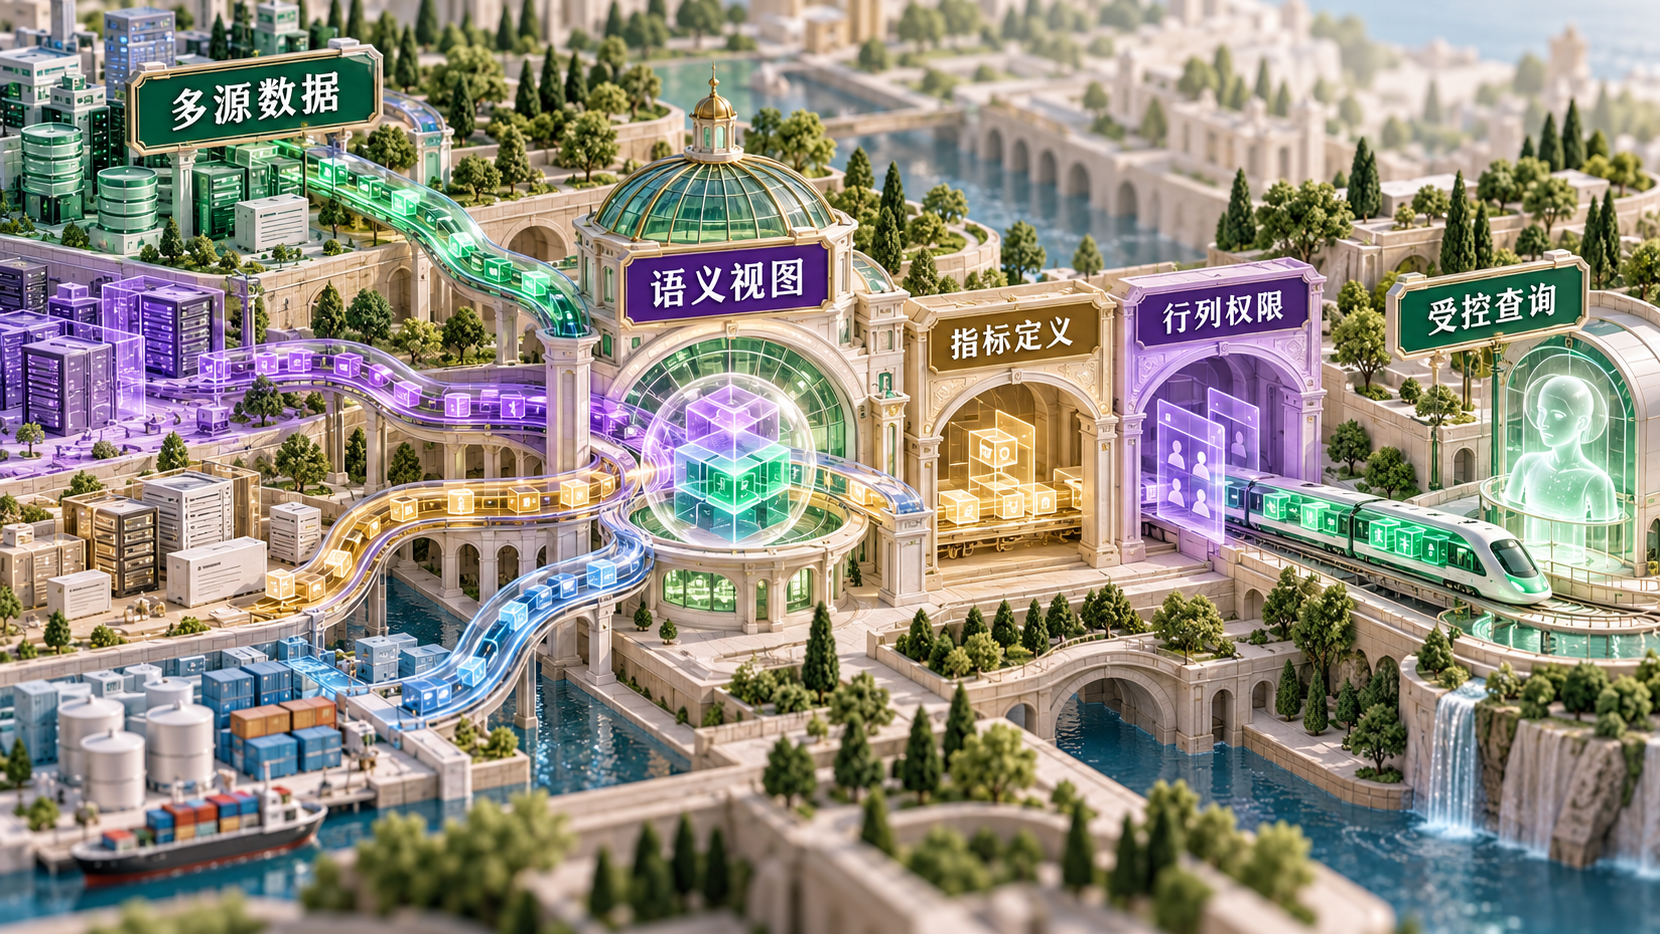
2026 年 10 月 20 日,AWS 与 Denodo 发布 Agentic AI 语义层参考架构:Aurora、Redshift 与本地 PostgreSQL 被虚拟化为统一 Customer 360 视图,Agent 通过 MCP 使用 VQL 查询;终端用户身份通过 On-Behalf-Of token 传播,行级和列级策略在语义层执行。
这解决企业 Agent 最危险的数据模式之一:让模型看到物理 schema,自行猜连接条件、指标定义和权限过滤。即使生成的 SQL 能运行,也可能把 revenue 与净收入混淆,或漏掉 tenant_id 条件。
模型负责选择业务问题的查询路径,语义层负责定义“这个指标究竟是什么、这个人究竟能看什么”。
把物理表隐藏在业务视图之后
语义层将源表映射为 base view,再用 derived view 定义跨源 Customer 360,用 metric view 固定业务指标。示意 VQL:
CREATE VIEW customer_360 AS
SELECT
  c.cid,
  c.segment,
  SUM(o.quantity * o.price) AS lifetime_spend,
  CASE WHEN r.account_id IS NULL THEN false ELSE true END AS rewards_member
FROM customer c
LEFT JOIN orders o ON c.cid = o.cid
LEFT JOIN rewards_account r ON c.cid = r.cid
GROUP BY c.cid, c.segment, r.account_id;
真实实现要将金额币种、退货、税和有效订单状态封装成 metric,而不是让每个 Agent 重写 SUM。指标变更只在语义层发布一次,所有 Agent 与 BI 消费者共同继承。
身份必须到达查询执行点
AgentCore 接收用户身份,通过 OBO token exchange 获取面向 Denodo 的短期凭证。MCP Server 不用共享服务账号执行所有查询;语义层看到真实用户/角色,并在执行时应用过滤。
token = identity.exchange_on_behalf_of(
    subject_token=user_token,
    audience="denodo-mcp",
    scopes=["customer360:query"],
    ttl_seconds=300,
)

result = mcp.call_tool(
    "run_governed_query",
    {"view": "customer_360", "question": question},
    bearer=token,
)
租户与地区条件由数据策略从身份派生,不由模型生成。敏感列如 SSN、卡号即使出现在物理表,也不会进入 Agent 可见 schema。
MCP 工具要限制查询表面
不要提供任意 execute_sql(sql)。更安全的工具只允许访问批准视图,先解析和检查查询计划,再施加行数、运行时间和成本上限:
{
  "name": "query_customer_360",
  "input": {
    "dimensions": ["segment", "state"],
    "metrics": ["lifetime_spend", "order_count"],
    "filters": [{"field": "state", "op": "in", "values": ["CA"]}],
    "limit": 100
  }
}
模型选择业务字段,服务端编译 VQL。对需要自由查询的分析场景,也要 AST allowlist、禁止 DDL/DML、限制跨源扫描并在执行前估算成本。
零拷贝联邦仍有性能边界
语义层在查询时决定哪些计算下推 Aurora/Redshift、哪些数据从本地 PostgreSQL 拉取并合并。它减少 ETL 副本,却不会消除跨网络延迟和源系统压力。常用指标可缓存或物化;在线事务库设置资源组与只读副本;长查询转异步任务。
Agent 应接收查询计划摘要和新鲜度信息。某个源不可用时,不能用缓存旧数据生成确定语气的答案,必须标记数据截止时间与缺失范围。
语义层也需要软件工程纪律
视图、metric 和策略进入 Git,运行静态检查、契约测试和示例问题回归。发布时验证同一问题在旧/新版本的差异,并把语义层版本写入 Agent trace。
重点指标包括查询正确率、策略拒绝正确率、跨源扫描量、P95 延迟、缓存陈旧度、模型生成无效字段率和每个业务答案的成本。企业 Agent 平台若没有语义层,只是把自然语言放在数据库前;有了受治理语义层,Agent 才能在不拥有底层数据逻辑的情况下稳定回答业务问题。